
循环深度、隐藏思维链与循环Transformer块的最新研究
过去几周发生了很多事。我确信OpenAI的GPT-6 Astra是目前所有人最关注的焦点。尤其是关于它的性能、循环Transformer/循环深度方面的讨论,以及Astra正在“隐藏”其推理轨迹(即思维链)的传言。因此,在这篇文章中,我想先谈谈对Astra的一些初步印象以及我对未来走向的思考。然后,我会详细讨论什么是“循环Transformer”,以及它(或者说,它是否)与隐藏思维链有关。最后,在介绍完循环Transformer的基础知识后,我想重点分享一些近期研究论文中关于这一主题的新见解。
- GPT-6 Astra印象
先说最重要的。在深入架构传言和相关研究文献之前,让我简要总结一些关于GPT-6 Astra的观察和细节。
上周,OpenAI高调发布了新的GPT-6 Astra。过去几天我一直在使用它,这是一个极其出色的模型,很可能是截至本文写作时我用过的最好的模型。但具体来说,它改进了什么,又是如何改进的?
1.1 Astra基准测试
Astra是我目前用过的最好的模型,并且在3D渲染和动画任务上表现异常出色(相对于其他模型而言)。我的意思是,虽然它在几乎所有类别(写作、数学、编程等)上都大幅超越了前代GPT-5.6,但在图形演示方面优势尤为突出。这一点在基准测试中也有所体现。
例如,GPT-6 Astra在数学和编程方面确实非常出色,如下图所示。其中一个亮点(图中未显示)是Astra在ARC-AGI-3基准测试中达到了99.9%的成绩(GPT-5.6 Sol仅为7.8%),该基准测试衡量的是逻辑谜题求解和泛化能力的综合表现。不过,数学、编程和计算机使用基准测试更有意思,因为它们更接近实际应用场景。
回到Artificial Analysis编程智能体指数v1.4(前图右下角),该指数综合了多项智能体编程任务,GPT-6 Astra显然处于前沿,但并没有遥遥领先。这也可以从下面展示的通用Artificial Analysis智能指数中看出,该指数混合了不同类型的任务,而不仅仅是编程任务。
Artificial Analysis基准测试的一大优势在于它们是独立的,因此可能比模型开发者自评的基准测试更值得信赖。测试框架的设置取决于具体的基准测试。例如,GDPval-AA和AA-Briefcase在不同LLM比较中使用其开源的极简Stirrup框架。在上面展示的智能指数v4.2中,Terminal-Bench v2.1使用Terminus 2,τ³-Banking使用τ-Bench框架。单独的编程智能体指数也比较了不同的编程智能体框架。
对于使用共享框架的评估,这更接近于同类比较。同时,在模型训练过程中,模型通常是以一个主要框架为核心来开发的(在其他框架上的微调较少)。而且,主要框架往往是为了适配和放大模型优势而开发的。因此,一些智能体评估可能低估了Astra在其主要框架中的表现。这对智能指数得分的影响程度,需要通过在同一任务上跨框架比较Astra来验证。
顺便说一句,正如一位同事最近向我建议的(Claude Code负责人也这么推荐),删除(/归档)一些现有的AGENTS.md内容和SKILL.md文件也许不是个坏主意,因为较新的LLM在理解提示和解决当前问题方面已经变得更加高效。过多的手把手指导可能会不必要地限制较新的模型,导致更差的解决方案。当然,我不是建议永远不再使用SKILL.md文件,因为在某些工作流程中,它们可以在复用时提高效率,因为模型不必重新发现这些内容。但我想说的是,有些工作流程不需要描述,“旧的”描述可能不再理想,LLM可能能够想出更好的解决方案。所以,也许是时候更新或重新生成这些指令文件了。
1.2 计算机使用能力
GPT-6 Astra在图像和渲染任务上似乎异常强大。当这些任务涉及与图形用户界面交互时,它们也展示了计算机使用能力,即模型通过Codex/ChatGPT应用在你的本地计算机上操作软件。计算机使用是模型真正脱颖而出之处,任何与图形相关的内容也能在社交媒体平台上产生有趣且直观的演示。
网上有大量令人印象深刻的演示示例,从在Blender中渲染纽约市到虚拟看房游览。举一个例子,下面是我让GPT-6 Astra Medium和High在浏览器版MS Paint中用鼠标重绘我的照片的对比(不是Extra High和Max,因为我不想浪费所有token :))。这不仅展示了模型的绘画能力,更重要的是,它展示了在计算机上使用工具的能力(在这个例子中是Paint;你可以看到模型通过鼠标光标使用界面)。
这并不是第一个能在框架内实现通用计算机使用的模型。例如,从今年早些时候开始,我就成功使用GPT模型完成了一些UI任务(如Excel中的费用相关任务)等。然而,计算机使用是一种相对较新的能力,由框架驱动,通常感觉还不够成熟。这很正常。LLM是文本模型,所以自然更容易实现的是写作、编程以及使用API和CLI。同时,有许多工具和软件(还)没有暴露CLI,与其等待有人设计出那个接口,为什么不改进模型来使用图形用户界面呢(而且,如前所述,这也能产生漂亮且令人印象深刻的演示)?这在某种程度上类似于新兴的人形机器人发展。当然,人形机器人不是最高效的机器人,例如在流水线上,有专用机器存在。但它们是多功能的。因此,我预计未来几个月(或几年)也将是LLM和智能体框架层面计算机使用能力不断完善的时期。也就是说,除了当前能力之外,在扩展数学和编程能力的同时,模型将越来越注重计算机使用的训练。这也将使LLM更容易用于技术世界之外的日常计算机任务(“嘿ChatGPT,请帮我报税” :))
1.3 计算机使用训练
计算机使用的趋势也与最近的报道一致,即OpenAI购买了数万台Mac Mini和Mac Studio用于强化学习。这里Mac并不是用来字面意义上训练模型的(训练模型最好用GPU),而是为了在模型训练期间暴露macOS,让模型学习使用该操作系统及其中的工具。
那么,在这些Mac上的计算机使用训练是如何工作的?简而言之,Mac(或者更准确地说,它们的macOS操作系统)充当了模型在训练期间可以交互的环境。基本工作流程如下:
- 通过给模型一个任务来提示它,例如“打开应用xyz并执行abc”。
- 向它提供macOS界面的截图(这通常由框架完成)。
- LLM然后预测鼠标/键盘操作(点击、按键、滚动等)。
- 在Mac上执行这些操作(同样,由框架完成)。
- 在完成上一步操作后,提供更新后环境的新截图。
- 重复步骤2-5,直到任务成功或失败。
- 使用成功/失败信号和验证器(或评分器)作为训练反馈,包括后训练期间的强化学习;这类似于常规的可验证奖励强化学习(RLVR)。
再次强调,Mac在这里主要是环境,而不是训练期间运行或更新模型的机器。模型很可能运行在NVIDIA GPU上,并通过API提供给这些Mac。顺便说一句,NVIDIA的CEO提到GPT-6 Astra是在约10万个Grace Blackwell GPU上训练的。
1.4 GPT-6 Astra仍然是一个推理模型
上一节讨论的计算机使用训练重点并不是训练流程的根本性范式转变。GPT-6 Astra(以及未来可预见的任何LLM)仍然是一个推理模型。这意味着LLM通过可验证奖励强化学习(RLVR)进行训练,并产生中间推理轨迹(思维链)。但我将在本文稍后部分讨论GPT-6 Astra的推理模型方面(特别是关于隐藏思维链的问题)。
- 循环Transformer
话虽如此,在官方模型发布约两天前,新闻杂志《The Information》发表了一篇文章,报道称根据一些内部消息,Astra正在使用一种叫做“循环深度”或“循环Transformer”的概念。由于LLM架构是我的专业领域和热情所在,我制作了一个简短的讲座视频,解释了一般的循环Transformer机制,并回应了关于隐藏推理链的评论,你可以在下面找到。
在接下来的小节中,我将首先解释什么是循环Transformer,然后在本文后面重新讨论关于隐藏思维链的评论。(循环Transformer的解释可能看起来有点长,但我真的认为它有助于建立对这一技术的基础理解,这对于判断它是否模糊了推理轨迹或思维链的说法很有用。)
2.1 复用Transformer块
那么,什么是循环Transformer?循环Transformer本质上是一种架构调整,其主要思想是将中间表示多次通过相同的Transformer块(而不是只通过一次)。与仅仅添加更多块相比,这里的“技巧”在于权重在这些传递过程中保持不变。
定义与术语
在本文中,我将使用以下术语:
· Transformer块:包含注意力、前馈模块、归一化和快捷连接的单元。这些块在论文中通常被称为“Transformer层”。
· 堆栈:一系列Transformer块的序列。
· 块应用:将输入通过一个Transformer块运行一次。
循环Transformer并不是什么新东西,其基本思想已经出现在2018年的Universal Transformers论文中。但在讨论Universal Transformer之前,让我们从一个更简单的例子开始:Nanbeige4.2-3B,这是今年7月发布的一个近期开源权重LLM,我今年夏天早些时候在Substack笔记和我的LLM架构画廊中介绍过它。
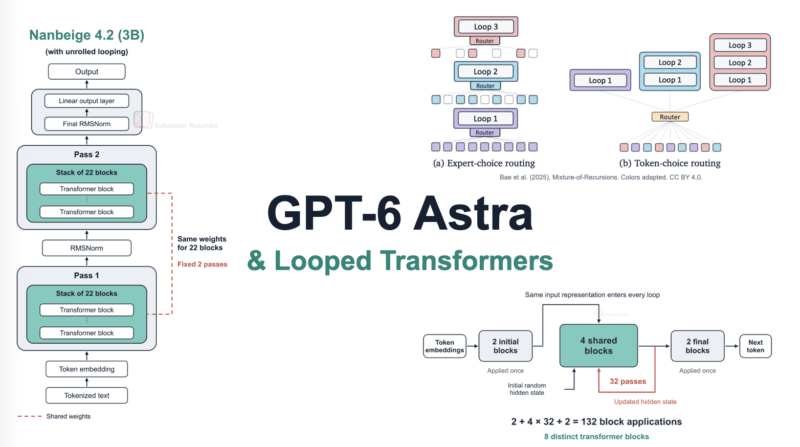
Nanbeige的架构,如下图所示,本质上看起来像一个常规的Transformer。然而,请注意它有一个额外的(橙色)箭头循环回Transformer堆栈的开头。让我们从下往上走一遍。首先,与任何其他基于Transformer的LLM一样,输入文本被分词并转换为嵌入向量。这些向量然后通过22个Transformer块,这22个块每个都有自己的权重。然而,这里的循环Transformer特性在于,第一遍之后,隐藏状态被反馈通过同样的22个块。所以,块1再次被应用,然后是块2,依此类推直到块22。如果我们展开这个计算,我们将有44次Transformer块应用。然而,与具有44个不同块的常规Transformer相比,第二组22次块应用复用了第一组的权重。例如,第23次块应用使用块1的权重,第24次块应用使用块2的权重,依此类推。所以,这里的整个想法是,我们将有效深度从22次块应用增加到44次,而不添加另一组Transformer权重。
顺便说一句,为什么是2轮而不是3、4或更多?Nanbeige论文中没有太多细节,但他们说这基本上是最有效的设置。将循环从2增加到3可以提高建模性能,但额外的计算成本不值得。
2.2 循环的成本
那么,为什么我们一般要做这种循环?这本质上是使模型变大(通过添加更多Transformer块)的一种替代方案。例如,一个使用22个Transformer块两次的模型,其(Transformer块)参数量大约是具有44个常规块的模型的一半。这减少了存储权重所需的内存。顺便说一句,请注意嵌入层和输出层通常很大,占总参数量的很大一部分,它们不在这个比较范围内。(在Nanbeige 4.2 3B的情况下,嵌入层和输出层约占3B总参数量的25%;如果在这两者之间共享权重,可以将其减少到12.5%。)
当然,在循环中复用相同的块仍然需要计算。更准确地说,我们让中间输入在正向传播中通过44次块应用。而且,在训练期间,梯度会反向流过共享堆栈的两次重复。所以,与只使用22个块一次相比,这增加了大量工作。实际上,它的开销与拥有44个不同块相似(除了优化器需要更新的不同参数更少;反向传播仍然要跑完所有44次块应用)。
还有KV缓存,它存储之前token的注意力键和值,以便在常规和循环Transformer的每个下一token生成步骤中复用。顺便说一句,我有一篇关于KV缓存的独立文章,如果有用的话:但回到主题。尽管循环Transformer中存在权重共享,但进入块的中间状态在第二遍时是不同的。因此,在KV缓存中,两个Transformer堆栈产生的键和值也是不同的(就像在非循环情况下一样)。所以,也没有KV缓存相关的节省。更具体地说,例如,考虑块应用1和23,在循环Transformer设置中它们都使用块1。但每次应用仍然需要自己的KV缓存条目。因此,由于我们必须为两遍保留单独的缓存,重复的22个块堆栈与具有44个不同块的常规Transformer具有相同的KV缓存需求。
有趣的是,Nanbeige研究人员在论文中报告说,他们尝试在传递之间共享KV缓存。这当然将KV缓存大小减半,但模型表现比使用单独缓存的版本更差(也就是他们发布的版本)。
在继续讨论其他循环Transformer设计之前,先完成Nanbeige的讨论,他们的技术报告还讨论了另外两个选择或权衡。从头训练循环架构比通过升级改造转换已经预训练的Transformer效果更好。而且,两次传递给出了他们偏好的权衡,如上一节所述。更多传递只带来微小的额外收益,同时减慢训练速度并使优化不太稳定。所以,传递次数是我们要做的另一个架构选择。如前所述,在Nanbeige中,这固定为2。但我们也可以让它依赖于token,我们接下来会看到。
2.3 Universal Transformer与灵活循环次数
现在,让我们回到Universal Transformers。在Nanbeige中,我们将22个Transformer块的堆栈应用两次。在2018年的Universal Transformer论文中,我们反复应用同一个Transformer块,而不是重复一个Transformer块堆栈。不过,主要思想是相似的。此外,步数可以是固定的,但论文也探索了自适应停止。例如,特定位置的token可能只经过一两次循环。另一个可能经过三四次循环,依此类推。这给模型提供了灵活性,将计算分配给那些受益于额外计算的token。
循环次数是如何决定的?这里,模型使用一个小型的训练函数,在每一步为每个位置输出所谓的停止概率。它将这些概率在连续的循环中累加,然后当总和超过阈值时,在给定位置停止循环。此外,最大循环次数也限制了计算以防万一。
循环Transformer的另一个例子是字节跳动的Ouro,我也在我的LLM架构画廊中介绍过它。例如,Ouro-Thinking 2.6B将相同的48个Transformer块堆栈应用四次。这是192次块应用,同时只存储48个不同块的权重。基本上,这比Nanbeige更极端。此外,一个学习到的退出门为不同的出口分配概率,累积概率的阈值决定哪次传递提供输出。所以,它也借鉴了Universal Transformer的自适应停止思想,而Nanbeige没有使用这个。(然而,这里有一个实际注意事项。发布的Hugging Face实现会在选择输出之前计算所有配置的传递,所以循环次数似乎实际上被硬编码为4。)
2.4 路由灵活循环次数
另一种方法是Mixture-of-Recursions,这是2025年的一篇论文,本质上是前面讨论的Universal Transformer的更复杂版本。与Universal Transformer类似,单个token会多次通过Transformer块,如下图所示。然而,创新之处在于如何基于每个token来确定循环次数。
在下面来自论文的图中,循环(重复)堆栈在这里被称为递归块。它包含几个Transformer块,位于单独的第一个和最后一个Transformer块之间(标记为Layer 0和Layer L-1)。
模型如何决定一个token应该通过递归块多少次?在之前讨论的Universal Transformer中,它基于每一步的学习停止概率。这里的Mixture-of-Recursion方法使用一个小型的学习路由器。这类似于混合专家模型中的路由思想,只不过这里的路由决策决定应用共享堆栈多少次。路由器作用于token的隐藏表示,其中也包含关于其上下文的信息。所以,我们不应该把这理解为给特定token的每次出现分配相同的传递次数(即,上图中的“People”这个词并不总是经过3次循环)。决策可以根据该词出现的位置以及它之前的内容而改变。
那么,路由具体是如何工作的?论文探索了两种做路由决策的方式,如下图所示。在专家选择路由中(如上图左侧子面板所示),每个递归步骤选择它将处理哪些token。退出的token被排除在后续步骤之外。在token选择路由中(如右侧所示),路由器在开始时做出一次决策,将每个token分配到经过一次、两次或三次传递的路径。在两种情况下,Transformer权重在传递之间被复用,与Nanbeige等类似。但额外的灵活性来自于选择每个token获得多少计算。模型及其路由器一起训练,因此模型在训练期间学会使用这些不同的路径。
2.5 效果如何?
下面来自Mixture-of-Recursions论文的图表比较了常规Transformer(Vanilla)、固定递归Transformer(Recursive)和Mixture-of-Recursions(MoR)在不同模型规模和计算预算(x轴)下的表现。在最小的模型规模下,常规Transformer表现最好。对于较大的模型,Mixture-of-Recursions赶上来并且通常表现更好,特别是在较小的训练预算下。在最大的预算下,几条曲线非常接近。所以,优势取决于模型规模和我们花在训练上的计算量。
这里的另一个细节是,相同的训练计算量并不一定意味着相同数量的训练token。通过跳过一些计算,Mixture-of-Recursions可以在相同的预算内处理更多token。我认为这是一个有趣的例子,因为它表明循环Transformer思想中存在多种选择,即每个位置有多少次循环以及如何决定。简而言之,我们可以说,如果模型足够大,在固定的计算预算下,使用循环Transformer可以提高模型质量。(这也说明了在规模上运行一些实验的重要性;例如,只看较小的135M参数模型,我们会得出相反的结论。)
- 旁注:循环神经网络(RNN)
顺便说一句,如果你有深度学习(甚至1990年代的人工神经网络)背景,循环或“循环深度”的想法应该有些熟悉。还记得循环神经网络(RNN)吗?RNN的整个思想就是复用前一次迭代的层(权重)。主要区别在于,RNN在时间步之间复用权重。也就是说,隐藏状态从一个token传递到下一个token。在循环Transformer中,token的循环是在架构深度上进行的。或者换句话说,在常规RNN中,每一步取输入序列中的下一个元素和前一步的隐藏状态。所以,当RNN处理一段文本时,它一次读取一个词或token,并在其隐藏状态中携带来自前面词的信息。在循环Transformer中,给定token的中间表示会多次通过Transformer堆栈。模型仍然使用注意力在token之间传递信息。
如果这个类比有点太令人困惑,不要太担心。也许更简单的理解循环Transformer的方式是将其视为复用Transformer块,类似于使模型变大但带有权重共享。
- Astra真的使用循环Transformer吗?
在我们讨论循环Transformer机制是否如之前《The Information》引述中所传言的那样模糊了推理轨迹之前,GPT-6 Astra真的使用了循环Transformer概念吗?我们必须记住,这仍然只是一个传言或独家消息,没有官方确认。如果模型是开源权重的,我们当然可以自己验证,但在这种情况下,我们必须依赖未经证实的报道。
然而,我认为GPT-6 Astra极有可能使用了循环Transformer的某些方面。首先,有上面提到的报道。其次,这是一种在过去研究中显示出前景的技术(如前所述),那为什么不呢?第三,OpenAI的首席科学家说了以下内容:
[…] 我们当前前沿模型(包括Astra)的计算图深度在GPT-4的两倍以内。[…]
然而,这并没有明确确认循环Transformer架构,也可能只是意味着他们使用了两倍的常规Transformer块。在我看来,Astra背后的成功(即良好的建模性能)可能主要归因于其他原因,即改进的训练配方和训练数据。循环Transformer的调整可能有所帮助,但我认为《The Information》高估了它的贡献。
- 隐藏思维链
接下来,让我们最终谈谈那个显而易见的问题:循环Transformer是否模糊了推理轨迹?
首先,OpenAI从一开始(至少从OpenAI o1开始)就向用户隐藏了(大部分)推理轨迹。所以,对于最终用户来说,不应该有太大区别。因此,解释性方面的担忧主要是针对模型开发者的。
无论如何,我不认为循环Transformer是隐藏或模糊思维链的重要因素。为了解释我自己的推理(不是双关语),让我们退一步,解释推理模型是如何工作的。
5.1 推理简述
推理模型通常会在产生最终答案之前生成中间步骤。这些步骤使用常规文本token(在某些用户界面中可选择对用户隐藏),被称为推理轨迹或思维链。
例如,假设我们要求两个数,它们的和是10,积是21。在下图中,模型首先尝试5和5。虽然和是正确的,但积是25,不是21。接下来,它尝试3和7,并再次检查两个条件。该图说明了推理模型如何“推理”,包括回溯。也就是说,模型注意到错误,然后重新审视之前的选择,然后继续不同的方法。请注意,模型仍然一次生成一个token,使用提示和之前的token作为上下文。所以,这些中间步骤充当草稿纸,在最终答案之前增加计算。最终答案可能比之前的推理轨迹短得多,如上面的例子所示。(OpenAI倾向于向用户隐藏大部分推理轨迹。)
关于理解和开发推理模型的更多细节,我推荐我的书《从零构建推理模型》。
5.2 Token使用与更短的思维链
现在,推理轨迹中的额外token会增加更多计算。循环Transformer增加了更多计算,因为token要通过更多Transformer块。有人可能会说,一个内部使用更多计算的模型不需要那么多外部思考token。
下面是GPT-6基准测试的一个选集,x轴是输出token数。我们可以看到,GPT-6 Astra在各个努力级别上并不一定比其前代GPT 5.6 Sol使用更少的token。然而,在固定准确率下,GPT-6 Astra确实比GPT 5.6 Sol使用更少的token。
这对可解释性是一个问题吗?不一定。使用更少的token可能只是意味着模型更有能力,犯的错误更少,使用更少的回溯,等等。也就是说,它可能只是第一次就把更多事情做对了。对我来说,这并没有立即引起关于可解释性的担忧。我的意思是,之前的模型也是如此。我认为没有人强烈担心GPT 5.6 Sol比更小的GPT 5.6 Luna模型可解释性差那么多,后者在相同的任务性能下使用更多的token,如下所示。事实上,我们可以看到Luna在相似的建模性能下比Sol多使用80%的token。这会让Sol的可解释性差那么多吗?相反,这里更合理的答案是,更有能力(更大、训练良好、使用更多计算)的模型可以更高效地解决问题,这里的“高效”意味着更少的token。
同样值得记住的是,推理轨迹并不保证忠实地描述模型内部发生的一切。在我看来,唯一有效的担忧是循环Transformer是否比常规Transformer更频繁地通过呈现“虚假”推理轨迹来故意误导用户。但我认为我们没有强有力的证据表明这种情况正在发生。
现在,Astra的系统卡确实指出,也有证据表明其推理轨迹的可监控性有所降低,相对于Sol有一点退步。这主要与更短、信息量更少的轨迹有关。但同样,这并不能确定循环是根本原因。这可能只是由于长度更短,类似于上面Luna与Sol的例子。
在我分享关于循环Transformer与隐藏推理链的想法几个小时后,Jakub Pachocki(OpenAI首席科学家)也分享了以下澄清:
我想防止因混乱报道而引发的不可监控性竞赛。我们当前前沿模型(包括Astra)的计算图深度在GPT-4的两倍以内。OpenAI从我们的第一个推理模型开始就一直致力于保持和利用思维链监控。我们深深关心这项技术,因为它可以让我们了解模型对齐如何从其训练分布中泛化。我确实认为它是脆弱的,并且不幸地呈负面趋势,原因与架构变化无关,我很快会写这方面的内容。但我们可以做一些事情来加强它,这是我们当前研究计划的核心目标。
“混乱报道”很可能指的是《The Information》上述段落,暗示循环方面与思维链变化没有任何关系。
- 循环Transformer研究
最后,我想分享一些与循环Transformer架构相关的有趣论文,超越我们已经讨论过的那些。
6.1 潜在推理
与Universal Transformer相关,2025年的论文《Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach》研究了模型如何在推理时使用额外的循环。为此,他们在800B token上训练了一个相对适中但也不是超级小的3.5B参数模型。与Universal Transformer中反复复用同一个块不同,它像Nanbeige一样重复一个堆栈;然而,与Nanbeige不同的是,它将这个由四个块组成的共享堆栈夹在2个初始块和2个最终块之间。另外,与Nanbeige的不同之处在于,共享堆栈在每次循环开始时接收初始块的输出,此外还接收上一次循环的隐藏状态。这些被拼接并通过一个学习到的线性投影,然后进入四个共享块。你可以把这理解为让堆栈在每次传递时都能访问相同的初始输入表示。整个布局总结在下面的图中。
简而言之,这是一个额外且有趣的循环Transformer变体。一个有趣的细节是,研究人员在训练期间改变循环次数。这为模型在推理时使用不同计算量做好了准备。在训练期间,循环次数是随机采样的。在推理时,由运行模型的人选择固定预算,例如8、32或64次循环。此外…




- 最新
- 最热
只看作者